TypeSafe non ha pubblicato l’architettura di Jev, i suoi pesi né un technical paper. Ha dichiarato che il modello è basato su transformer, che è addestrato solo su dati sintetici e che non è autoregressivo, cioè non produce la risposta un token dopo l’altro. Secondo TypeSafe, Jev usa una nuova architettura con un parallel sampler, produce tutte le risposte in una sola query e valuta in parallelo e in modo indipendente le domande poste sullo stesso stato. Le probabilità sono calibrate con un post-training che TypeSafe chiama RLCD (Reinforcement Learning for Calibrated Decisions), che le confronta con gli esiti osservati e le corregge.
Non si sa se Jev sia un encoder, un decoder o altro. L’ipotesi che sia costruito su un LLM (large language model) con pesi pubblici circola tra osservatori esterni, ma non è confermata.
Quanto segue è tutto il percorso che ho intrapreso pensando a come raggiungere lo stesso risultato.
L’architettura finale è basata su encoder, ma ho pensato potesse essere divertente mostrare tutto il ragionamento che mi ha portato ad escludere la strada del decoder
Il punto di partenza è una domanda che mi sono posto pensando a Jev: “dato che i problemi decisionali sono molto verticali, perché non costruire un’architettura su un modello piccolo basato su BERT, predisposto ad un fine-tuning facile e veloce?”.
Repository
https://github.com/Flab/majev-bb
Premesse importanti
La prima e la più importante. Questo non è un paper e l’architettura descritta qui, encoder condiviso, una classification head per domanda e temperature scaling per calibrarle separatamente, non è una novità. Quindi tratto una combinazione di componenti ben note, dai modelli multi-task su BERT come MT-DNN ai classificatori intent/slot usati nei sistemi di NLU (Natural Language Understanding) vocale. Il contributo che provo a portare non sta quindi nell’architettura in sé, ma nel percorso fatto giocando a riprodurre l’approccio di un sistema di cui non si sa nulla
La seconda è che il mio modo di procedere parte sempre prima dalla matematica per poi passare al codice. Quest’ultimo l’ho rilasciato su github e ammetto essere la parte meno curata, quindi, ripeto, prendete il tutto per quel che è, un esperimento. C’è comunque il minimo necessario per provare, nulla di che.
L’ultima premessa sta nel fatto che ho cercato di riadattare tutti gli appunti in un discorso organico, il tentativo di condivedere un ragionamento fatto la sera sul mio remarkable, scrivendo papiri di formule a mo’ di flusso di coscienza.
Nel caso ci fossero parti spiegate in modo poco esaustivo, domande, osservazioni e correzioni sono bene accette.
Cosa è emerso dalla sperimentazione
Comincio dalla fine, dal risultato degli esperimenti che ho condotto. Non fa parte del nucleo di appunti originale, ma è interessante perché in un certo qual modo mette in prospettiva un ragionamento che difatti è stato pensato prima.
Il codice che accompagna l’articolo contiene un esperimento completo. Il modello legge richieste di acquisto in italiano e controlla se rispettano la procedura aziendale riportata nel documento stesso. Le domande sono quattro. Il modello deve dire se c’è l’approvazione del Finance quando l’importo la richiede, se ci sono abbastanza preventivi formali, se la richiesta va approvata, sospesa o respinta, e quanto è urgente. La domanda di fondo è se un modello addestrato soltanto su documenti sintetici riesca a cavarsela con un documento reale.
I documenti di addestramento sono prodotti da uno script. Per ciascuno vengono estratte a caso le evidenze (importi, approvazioni ottenute, preventivi, fornitore) e le risposte corrette si ottengono applicando le regole della procedura. Il testo nasce da template con più formulazioni per ogni evidenza e con frasi pensate apposta per trarre in inganno, come un responsabile che scrive “procedi pure” in un commento o uno sconto proposto al telefono e mai messo per iscritto. Una parte dei documenti, 250 su 1.750, è invece scritta da un LLM locale a partire dalle stesse evidenze.
Sul validation set sintetico il modello risponde correttamente in una percentuale di casi compresa tra il 98 e il 100 per cento, con probabilità ben calibrate. Sul documento reale indovina due domande su tre e sbaglia quella sul confronto tra fornitori, perché scambia lo sconto offerto al telefono per un preventivo formale.
E lo sbaglia con sicurezza, con una probabilità di 0,85 nel run di riferimento.
Per capire se fosse un caso isolato ho ripetuto l’addestramento dieci volte con seed diversi, metà con i soli documenti da template e metà aggiungendo quelli scritti dall’LLM. L’errore compare in otto casi su dieci, con probabilità comprese tra 0,70 e 0,99, mentre l’approvazione del Finance e la decisione finale risultano sempre corrette.
Non si tratta quindi di una coincidenza, ma di un limite dei dati. Il generatore insegna bene la differenza tra preventivo formale e offerta informale nei documenti sintetici, dove la stessa domanda riceve la risposta giusta in quasi tutti i casi, ma non nella forma in cui la esprime il documento reale.
Non ho pensato di correggere il dataset proprio perché, in questo caso, credo sia più istruttivo ciò che non è andato per il verso giusto, dal momento chè l’erroe individua bene dove nasce l’errore.
Ed è proprio qui che arriva anche una lezione sulla calibrazione. Mi ripeterò spesso nel resto dell’articolo, su quanto questa parte sia importante. Il temperature scaling si fa sul validation set e se questo è sintetico il modello impara a “fidarsi di sé stesso” su questo tipo di documenti. Sul documento reale, invece quella sicurezza non significa nulla, perché il modello resta convinto sia quando ha ragione che quando sbaglia.
Per potersi fidare delle probabilità su documenti reali bisogna calibrare su documenti reali, anche se sono pochi.
Le prove ripetute hanno messo in luce anche un altro aspetto. Sulla GPU l’addestramento non è riproducibile bit per bit, nemmeno a parità di seed, perché alcune operazioni non sono deterministiche. I punteggi sul validation set sintetico restano quasi identici, ma sul singolo documento reale cambia la sicurezza e qualche volta perfino la risposta. Prima di trarre conclusioni conviene quindi addestrare più volte ogni variante e guardare l’andamento complessivo, ricordando che un solo documento reale è un banco di prova molto piccolo.
Rileggendo i testi prodotti dall’LLM è poi venuto fuori un problema che non avevo previsto. Il prompt indicava il livello di urgenza come punteggio, per esempio “4/5”, e l’LLM lo ricopiava nel documento. Per 210 documenti su 250 la risposta alla domanda sull’urgenza era quindi scritta nel testo, una scorciatoia che nessun documento reale offre.
Ho corretto il prompt facendo descrivere l’urgenza a parole e ho rigenerato i dati, ma la correzione ha avuto a sua volta un effetto collaterale.
Per descrivere la situazione il prompt usava le frasi dei template, e l’LLM le ha riprese quasi alla lettera, in 24 documenti in modo praticamente identico. Il risultato è che indovinare la risposta alla domanda sull’urgenza è diventato ancora più facile, con il cento per cento di risposte corrette sui dati sintetici e una sicurezza piena su quello reale.
Quello che si scrive nel prompt finisce nel testo, e con i dati sintetici un errore del genere passa inosservato finché non si leggono gli esempi uno per uno.
Quanto ai costi, l’addestramento ha richiesto circa due minuti su una GPU da portatile ed entra in 8 GB di VRAM con un batch size fino a 4. Funziona anche su CPU, dove però serve più tempo (dipende dalla CPU). L’inferenza su un documento di una pagina richiede invece circa 10 millisecondi su GPU e mezzo secondo su CPU.
Il repository non contiene modelli già addestrati, ed è una scelta voluta. Chi è interessato può rifare l’esperimento, modificare il generatore e osservare cosa cambia, oppure partire da un generatore minimo e da un file di configurazione modello per costruirne uno sul proprio dominio. La documentazione raccoglie i risultati, i costi e il registro di tutte le modifiche, e suggerisce alcune strade da esplorare.
Problema
Partiamo da un testo $x$, che viene fornito come contesto di riferimento comune per tutte le domande. Su questo stesso testo vengono quindi poste $Q$ domande. Infine affermiamo che la domanda $q$ ammette un insieme finito di risposte, numerate da $1$ a $K_q$.
$$ \mathcal{Y}_q = \{1, \dots, K_q\} $$Ciò che si vuole sostanzialmente ottenere, in un approccio simil-Jev è una distribuzione di probabilità su queste risposte.
Cioè un vettore così descritto:
$$ p^{(q)}(x) = \big( p^{(q)}_1(x), \dots, p^{(q)}_{K_q}(x) \big), $$- $p^{(q)}_k(x)$: è la probabilità che la risposta corretta alla domanda $q$ sul testo $x$ sia la $k$-esima.
- $(q)$: indica a quale domanda si riferisce la distribuzione
Inoltre ogni elemento è maggiore o uguale a zero e la loro somma uguale a 1:
- $p^{(q)}_k(x) \ge 0$
- $\sum_{k=1}^{K_q} p^{(q)}_k(x) = 1$
Il sistema non deve generare testo. La distribuzione serve a prendere decisioni e pertanto tra le altre cose dovrà essere calibrata. In pratica bisognerà far si che le sue probabilità dovranno coincidere con le frequenze reali con cui le risposte risultano corrette.
Come già detto da qui in poi si seguiranno due approcci diversi, uno basato sull’architettura decoder-only, l’altro encoder-only .
In generale, un’architettura encoder-only, come BERT, è progettata principalmente per comprendere e rappresentare il significato dell’input. Un’architettura decoder-only, come GPT, è progettata principalmente per generare testo prevedendo un token alla volta in base al contesto precedente.
Nascono in realtà entrambe dal paper che ha dato il via a tutto “attention is all you need”, dove vengono descritte come due parti di un’ unica architettura
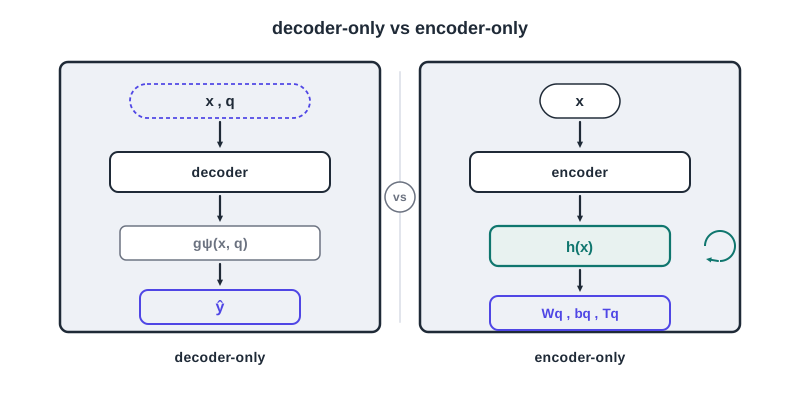
A sinistra il decoder-only. Testo e domanda entrano insieme nella sequenza e producono g(x,q), da cui si ricava la risposta ŷ. A destra l'encoder-only. Il testo produce una sola volta h(x), che si riusa per ogni domanda applicando i parametri Wq, bq, Tq della head corrispondente.
Entrambi gli approcci trasformano prima il testo in una sequenza di token, cioè di unità elementari come parole o parti di parola, prese da un vocabolario $\mathcal{V}$ che contiene $|\mathcal{V}|$ token.
Approccio decoder
Negli approcci decoder-only, il testo e la domanda, scritta in linguaggio naturale, formano un’unica sequenza, poi il decoder la elabora e produce un vettore associato all’ultima posizione della sequenza che definiamo come:
$$ g_\psi(x, q) \in \mathbb{R}^{d'} $$Qui $\psi$ indica l’insieme dei parametri del decoder e $d'$ la dimensione dei suoi vettori interni. Il vettore dipende sia dal testo $x$ sia dalla domanda $q$.
Distribuzione
A partire dal vettore prodotto dal decoder, possiamo ora determinare quanto ogni possibile risposta sia compatibile con il testo e con la domanda. Per farlo, il modello utilizza una matrice di output
$$ U \in \mathbb{R}^{|\mathcal{V}| \times d'} $$in cui ogni riga corrisponde a un token del vocabolario. La matrice è la stessa per tutte le domande, ma non tutti i token sono necessariamente risposte valide. Per questo motivo, consideriamo solamente le righe associate ai token che possono rappresentare le risposte ammesse alla domanda $q$. Questa parte della matrice viene indicata con
$$ U_{\mathcal{Y}_q}. $$Il vettore prodotto dal decoder viene quindi combinato con le righe della matrice di output associate alle possibili risposte.
Si ottiene così uno score per ciascuna risposta, che attraverso la funzione softmax viene trasformato in una probabilità. In questo modo otteniamo una distribuzione sulle risposte possibili.
$$ p^{(q)}(x) = \mathrm{softmax} \big( U_{\mathcal{Y}_q} \, g_\psi(x, q) \big) $$La softmax trasforma un vettore di numeri reali $z = (z_1, \dots, z_K)$ in una distribuzione di probabilità
$\mathrm{softmax}(z)_k = \frac{\exp(z_k)}{\sum_{k'=1}^{K} \exp(z{k'})}$
dove il numeratore rende ogni valore positivo e il denominatore, uguale per tutte le componenti, fa sì che la somma valga $1$. I numeri $z_k$ che entrano nella softmax si chiamano logit.
Maschera causale
Encoder e decoder utilizzano lo stesso meccanismo di base, chiamato self-attention. In questo meccanismo, ogni token aggiorna la propria rappresentazione tenendo conto degli altri token della sequenza, dando più peso a quelli con cui è maggiormente correlato.
Non sempre, però, è necessario o desiderabile che un token possa guardare tutti gli altri. Per stabilire quali token possono essere considerati, si utilizza una maschera, rappresentata da una matrice
$$ M \in \mathbb{R}^{L \times L} $$La maschera interviene sui punteggi che determinano quanto ogni token deve considerare gli altri, prima che questi vengano trasformati in pesi dalla softmax.
In particolare, l’elemento $M_{ii'}$ indica se il token nella posizione $i$ può considerare quello nella posizione $i'$. Se vale $0$, il token $i'$ può contribuire alla rappresentazione del token $i$. Mentre se vale $-\infty$, il suo contributo viene escluso, perché dopo la softmax gli viene assegnato peso nullo.
$$ M_{ii'} = \begin{cases} 0 & \text{se } i' \le i \\ \\ -\infty & \text{se } i' > i \end{cases} $$Quindi in un decoder la maschera è causale, cioè ogni token vede solo sé stesso e i token che lo precedono
Riutilizzo dello stato
Indichiamo con $t_1,\dots,t_L$ i token della sequenza e con $H_i$ la rappresentazione del token nella posizione $i$ all’uscita del modello.
Con la maschera causale, ogni token può utilizzare solo le informazioni che lo precedono nella sequenza, compreso sé stesso. In altre parole, $H_i$ dipende solo da $t_1,\dots,t_i$ e non dai token successivi.
Se la sequenza è formata prima dal testo e poi dalla domanda, le rappresentazioni dei token del testo non dipendono quindi dalla domanda. Questo significa che, una volta elaborato il testo, le informazioni necessarie per rappresentarlo possono essere calcolate una sola volta e poi riutilizzate per tutte le domande successive.
È proprio a questo scopo che serve la KV cache. Durante l’elaborazione, per ogni token e per ogni layer, la self-attention calcola infatti due vettori, chiamati key e value. Questi vettori vengono conservati nella cache, così da non doverli ricalcolare ogni volta che viene posta una nuova domanda sullo stesso testo.
La KV cache può quindi essere vista come una sorta di memoria condivisa del testo a cui il decoder può accedere mentre elabora le diverse domande. Per ogni token vengono conservati un vettore key e un vettore value per ciascun layer. Se il testo contiene $L$ token, la cache contiene complessivamente
$2 \cdot n_{\mathrm{layer}} \cdot L \cdot d_{\mathrm{kv}}$
numeri, dove il fattore $2$ tiene conto dei vettori key e value, $n_{\mathrm{layer}}$ è il numero di layer del decoder e $d_{\mathrm{kv}}$ è la dimensione di ciascun vettore.
Di conseguenza, più è lungo il testo, maggiore è la memoria necessaria per conservarne la KV cache.
Restrizione della distribuzione sulle risposte ammesse
Supponiamo che ogni possibile risposta $k$ corrisponda a un solo token del vocabolario, che indichiamo con $\tau_k$.
Il decoder assegna uno score, detto logit, a ciascun token del vocabolario. Tutti questi valori sono raccolti nel vettore
$$ u = U\,g_\psi(x,q) \in \mathbb{R}^{|\mathcal{V}|}, $$dove $u_{\tau_k}$ è il logit associato al token $\tau_k$ che rappresenta la risposta $k$.
Poiché ci interessano soltanto le risposte ammesse, possiamo ignorare i logit degli altri token e mantenere solamente quelli corrispondenti alle risposte possibili. Otteniamo così
$$ p^{(q)}_k(x) = \frac {\exp(u_{\tau_k})} {\sum_{k' \in \mathcal{Y}_q} \exp(u_{\tau_{k'}})} = \frac {P(\tau_k \mid x, q)} {P(\mathcal{Y}_q \mid x, q)} $$Dove:
- $P(\tau_k \mid x, q)$: è la probabilità che il decoder assegna al token $\tau_k$ calcolando la softmax su tutto il vocabolario
- $P(\mathcal{Y}_q \mid x, q) = \sum_{k'} P(\tau_{k'} \mid x, q)$: è la probabilità complessiva di tutte le risposte ammesse.
La restrizione alle sole risposte ammesse può essere quindi interpretata come una probabilità condizionata.
In altre parole, invece di chiederci quale sia la probabilità della risposta $k$ tra tutti i token del vocabolario, ci chiediamo quale sia la sua probabilità sapendo che il modello ha prodotto una delle risposte ammesse.
La probabilità assegnata dal modello ai token che non corrispondono a una risposta ammessa viene quindi esclusa. In particolare, la quantità
$$ 1-P(\mathcal{Y}_q\mid x,q) $$rappresenta la probabilità che il modello aveva assegnato ai token al di fuori dell’insieme delle risposte ammesse.
Questa massa di probabilità viene eliminata e le probabilità rimanenti vengono rinormalizzate, in modo che la loro somma torni a 1.
Questo ragionamento è immediato quando ogni risposta corrisponde a un solo token. Quando invece una risposta è composta da più token, bisogna considerare anche come viene calcolata la sua probabilità.
Supponiamo quindi che la risposta $k$ sia formata dai token $\tau_{k,1},\dots,\tau_{k,n_k}$, dove $n_k$ indica il numero di token della risposta. La probabilità della risposta si ottiene moltiplicando le probabilità dei singoli token, ciascuno condizionato ai token precedenti. In forma logaritmica,
$$ \log P(k\mid x,q) = \sum_{r=1}^{n_k} \log P\big( \tau_{k,r}\mid x,q,\tau_{k,1},\dots,\tau_{k,r-1} \big). $$Questa formulazione introduce però un problema legato alla lunghezza.
Ogni probabilità è al massimo 1 e quindi il suo logaritmo è minore o uguale a 0. Ogni token aggiuntivo contribuisce quindi con un valore non positivo alla somma. Di conseguenza, una risposta più lunga tende ad avere una probabilità complessiva più bassa semplicemente perché contiene più token, anche quando non c’è una differenza nel loro significato.
La probabilità così calcolata introduce quindi una penalizzazione legata alla lunghezza. Per confrontare risposte di lunghezza diversa è necessario introdurre una regola di correzione della lunghezza.
Costo
Per capire quanto costa elaborare il testo e rispondere alle domande, consideriamo il numero di operazioni necessarie per far passare i token attraverso il decoder.
Indichiamo con $n_{\mathrm{dec}}$ il numero di parametri del decoder, escludendo quelli degli embedding, cioè dei vettori associati ai token del vocabolario. In prima approssimazione, elaborare un token attraverso tutta la rete richiede circa $2\,n_{\mathrm{dec}}$ operazioni, perché ogni parametro viene utilizzato in una moltiplicazione e in una somma.
Grazie alla KV cache, il testo viene elaborato una sola volta. Per ciascuna delle $Q$ domande, invece, il decoder deve elaborare soltanto i token della domanda.
Se $L$ è il numero di token del testo e $L_q$ il numero di token della domanda $q$, il costo complessivo è quindi circa
$$ C_{\mathrm{dec}} \approx 2\,n_{\mathrm{dec}} \left( L+\sum_{q=1}^{Q}L_q \right) $$Il punto importante è che la lunghezza del testo compare una sola volta nel costo, mentre ogni domanda contribuisce con i propri token. La KV cache permette quindi di riutilizzare il lavoro già svolto sul testo invece di ripeterlo per ogni nuova domanda.
Approccio encoder
Nell’approccio encoder-only, il testo viene elaborato una sola volta, senza includere la domanda.
L’encoder trasforma quindi il testo in un unico vettore
$$ h(x)\in\mathbb{R}^{d}, $$con $d=768$, che ne rappresenta il contenuto in una forma utilizzabile dal modello.
Poiché la domanda non entra nell’encoder, questo vettore dipende solo dal testo e può essere riutilizzato per tutte le domande successive.
Per ogni domanda $q$, il modello utilizza poi una propria trasformazione lineare, appresa durante l’addestramento, che prende il vettore $h(x)$ e produce uno score per ciascuna delle $K_q$ risposte possibili:
$$ p^{(q)}(x) = \mathrm{softmax} \left( \frac{W_q\,h(x)+b_q}{T_q} \right) $$La matrice $W_q\in\mathbb{R}^{K_q\times d}$ contiene una riga per ciascuna risposta, mentre $b_q\in\mathbb{R}^{K_q}$ contiene un termine associato a ciascuna risposta.
Il prodotto $W_qh(x)$ produce quindi $K_q$ valori, uno per ogni possibile risposta. La temperatura $T_q>0$ (più avanti vedremo nel dettaglio di cosa si tratta), controlla invece quanto queste probabilità risultano concentrate o distribuite.
In questo modo, il testo viene elaborato una sola volta dall’encoder, mentre per ogni nuova domanda è sufficiente applicare la relativa trasformazione al vettore già calcolato.
Riassunto l’approccio, vediamo come si ottiene $h(x)$ e come vengono appresi e utilizzati $W_q$, $b_q$ e $T_q$.
La pipeline di calcolo
$$ x \xrightarrow{\text{tokenizer}} (t_1, \dots, t_L),\, a \xrightarrow{\;E\;} X^{(0)} \xrightarrow{\;f_\theta\;} H \xrightarrow{\text{mean pooling}} h \xrightarrow{\;W_q,\, b_q\;} z^{(q)} \xrightarrow{\;\div T_q,\ \text{softmax}\;} p^{(q)} $$Ogni freccia rappresenta un passaggio di calcolo, che possiamo seguire partendo dal testo originale:
-
Il tokenizer divide il testo $x$ nei token $t_1,\dots,t_L$ e produce anche la attention mask $a$, che indica quali posizioni contengono token reali e quali sono invece occupate da token di riempimento.
-
La matrice degli embedding $E$ associa a ciascun token un vettore numerico. I vettori ottenuti vengono raccolti nella matrice $X^{(0)}$.
-
L’encoder $f_\theta$ elabora questi vettori tenendo conto delle relazioni tra tutti i token della sequenza e produce la matrice:
$H=f_\theta(X^{(0)},a).$
Ogni riga di $H$ contiene quindi la rappresentazione di un token dopo che questo ha potuto considerare il resto della frase.
-
Il mean pooling riassume tutte le rappresentazioni contenute in $H$ in un unico vettore $h$, che rappresenta complessivamente il testo.
-
A questo punto entra in gioco la domanda $q$. La head associata alla domanda prende $h$ e produce un logit $z^{(q)}$ per ciascuna delle possibili risposte.
-
Infine, i logit vengono divisi per la temperatura $T_q$ e passati alla softmax, ottenendo la distribuzione di probabilità $p^{(q)}$ sulle risposte.
Il punto importante è che tutto il calcolo fino a $h$ viene eseguito una sola volta, perché dipende esclusivamente dal testo.
Solo dopo $h$ il calcolo si separa in $Q$ rami indipendenti, uno per ciascuna domanda. Nel codice, questa struttura è implementata nella classe MultiHeadClassifier di src/model.py.
Tokenizer ed embedding
Per elaborare più testi insieme le sequenze devono avere la stessa lunghezza, quindi quelle più corte vengono allungate con un token speciale di riempimento, detto padding.
La attention mask è il vettore $a = (a_1, \dots, a_L)$ con
$$ a_i = \begin{cases} 1 & \text{se il token in posizione } i \text{ fa parte del testo} \\ \\ 0 & \text{se è un token di padding} \end{cases} $$La matrice degli embedding $E \in \mathbb{R}^{|\mathcal{V}| \times d}$ ha una riga di $d = 768$ valori per ogni token del vocabolario. Indicando con $E_{t}$ la riga del token $t$, la sequenza diventa la matrice:
$$ X^{(0)} = \begin{pmatrix} E_{t_1} \\ \vdots \\ E_{t_L} \end{pmatrix} \in \mathbb{R}^{L \times d} $$in cui la riga $i$ è l’embedding del token in posizione $i$.
A questo punto ogni riga descrive un token isolato e non contiene alcuna informazione sul resto della frase.
Encoder bidirezionale
L’encoder è mmBERT-base, un modello multilingue della famiglia BERT (Bidirectional Encoder Representations from Transformers).
Lo indichiamo con la funzione $f_\theta$, dove $\theta$ è l’insieme dei suoi parametri. Riceve $X^{(0)}$ e restituisce
$$ H = f_\theta(t_1, \dots, t_L) \in \mathbb{R}^{L \times d} $$una matrice con una riga $H_i \in \mathbb{R}^{d}$ per ogni token.
La sua self-attention usa una maschera che esclude solo i token di padding
$$ M_{ii'} = \begin{cases} 0 & \text{se } a_{i'} = 1 \\ \\ -\infty& \text{se } a_{i'} = 0 \end{cases} $$cioè il token in posizione $i$ può guardare qualunque token reale $i'$, sia prima sia dopo di sé. Per questo l’attention si dice bidirezionale, e ogni riga $H_i$ dipende dall’intero testo.
mmBERT in realtà appartiene alla famiglia ModernBERT e questa maschera vale per 8 dei suoi 22 layer, uno ogni tre, che usano un’attention globale.
Negli altri 14 l’attention è locale, quindi ogni token vede solo i 64 token che lo precedono e i 64 che lo seguono. Poiché i layer globali si alternano a quelli locali, al termine dell’encoder ogni $H_i$ dipende comunque dall’intero testo.
Ogni posizione contiene informazione su tutta la frase, ed è per questo che ha senso farne la media.
Mean pooling
Il mean pooling calcola la media delle righe di $H$ corrispondenti ai soli token reali
$$ h = \frac {\sum_{i=1}^{L} a_i \, H_i} {\sum_{i=1}^{L} a_i} \in \mathbb{R}^{d} $$Nel numeratore i token di padding hanno $a_i = 0$ e non contribuiscono alla somma, mentre denominatore conta i token reali.
Il vettore $h$ è lo stato condiviso del sistema e contiene $d = 768$ numeri, qualunque sia la lunghezza del testo. In un decoder la stessa operazione non avrebbe senso, perché le prime posizioni non hanno visto il resto del testo.
Le classification head
Per ogni domanda $q$ c’è una classification head, cioè un piccolo strato che prende il vettore $h$ prodotto dall’encoder e lo trasforma in uno score per ciascuna delle $K_q$ risposte possibili.
Questa trasformazione è definita dai parametri
$$ W_q\in\mathbb{R}^{K_q\times d} \qquad \text{e} \qquad b_q\in\mathbb{R}^{K_q}. $$Durante l’addestramento, prima della classification head viene applicato un dropout. Con probabilità $\rho=0{,}1$, ogni componente di $h$ viene temporaneamente azzerata. In questo modo il modello è spinto a distribuire l’informazione tra più componenti del vettore, invece di affidarsi eccessivamente a un piccolo gruppo di esse.
Il dropout è una tecnica usata durante l’addestramento per rendere il modello più robusto. Prima di passare alla classification head, alcune componenti del vettore $h$ vengono temporaneamente azzerate in modo casuale. Con un dropout $\rho=0{,}1$, ogni componente viene quindi esclusa con probabilità del 10%.
L’idea è abbastanza semplice. Il modello non può fare affidamento sempre sulle stesse componenti di $h$, ma deve imparare a distribuire l’informazione tra più componenti.
Questo aiuta a ridurre il rischio di overfitting, cioè che il modello impari troppo bene i dati di addestramento e funzioni peggio su dati nuovi.
Arrivati a questo punto la classification head trasforma il vettore $h$ in un punteggio per ciascuna delle possibili risposte:
$$ z^{(q)} = W_q \, h + b_q \in \mathbb{R}^{K_q} $$La componente $z^{(q)}_k$ è ottenuta combinando $h$ con la riga $k$ di $W_q$ e aggiungendo il corrispondente termine di $b_q$.
In particolare, il prodotto scalare tra $h$ e la riga $k$ di $W_q$ misura quanto la rappresentazione del testo è compatibile con quella risposta. Un valore alto indica quindi una maggiore compatibilità.
I logit vengono poi trasformati in probabilità attraverso la temperatura $T_q$ e la funzione softmax:
$$ p^{(q)}_k = \frac {\exp\big(z^{(q)}_k/T_q\big)} {\sum_{k'=1}^{K_q}\exp\big(z^{(q)}_{k'}/T_q\big)}. $$Il vettore $p^{(q)}$ contiene esattamente $K_q$ probabilità, una per ciascuna risposta ammessa.
Non vengono quindi considerate altre possibili risposte e, poiché ogni risposta corrisponde a una singola classe, non c’è il problema delle risposte composte da più token.
La risposta prevista è quella a cui il modello assegna la probabilità maggiore:
$$ \hat{y}^{(q)}=\arg\max_k p^{(q)}_k, \qquad \hat{c}^{(q)}=\max_k p^{(q)}_k. $$La quantità $\hat{c}^{(q)}$ rappresenta la confidence, cioè la probabilità che il modello assegna alla risposta che ha scelto.
È importante notare che, una volta calcolato $h$, ogni domanda viene gestita separatamente. La distribuzione $p^{(q)}$ dipende dal testo solo attraverso $h$ e, per quella specifica domanda, soltanto dai parametri $W_q$, $b_q$ e $T_q$. Le diverse domande non interagiscono quindi tra loro.
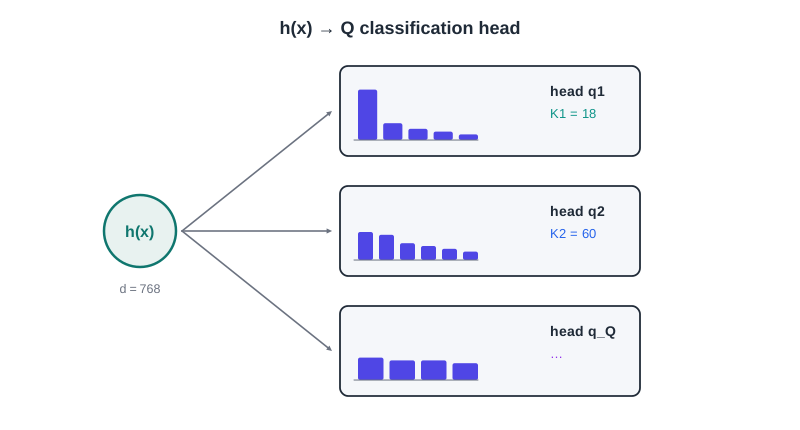
A partire dallo stesso vettore h(x), ogni domanda ha una propria head indipendente: pesi diversi, softmax diversa, numero di risposte diverso. Su MASSIVE le due head considerate hanno K = 18 e K = 60 risposte possibili.
Una head per ogni tipo di domanda
La classification head produce un logit per ciascuna possibile risposta, che viene poi trasformato in una probabilità attraverso la softmax. Il modo in cui queste probabilità vengono interpretate dipende però dalla natura delle risposte.
Quando le risposte sono categorie distinte e non ordinate, è sufficiente considerare quella con la probabilità più alta. Se invece le possibili risposte sono due, per esempio no e sì, la softmax produce due probabilità che sommano a 1. In questo caso la probabilità del sì può essere espressa in modo equivalente come una funzione sigmoide applicata alla differenza tra i due logit:
$$ p_{\text{sì}} = \frac{1}{1+\exp\big(-(z_{\text{sì}}-z_{\text{no}})\big)} $$Quando invece le risposte rappresentano livelli ordinati, $v_1 < v_2 < \dots < v_{K_q}$, le probabilità possono essere interpretate come una distribuzione lungo una scala. In questo caso, oltre a individuare il livello più probabile, possiamo calcolare il valore atteso, cioè la media dei livelli pesata con le rispettive probabilità:
$$ \mathbb{E}^{(q)}(x) = \sum_{k=1}^{K_q} p^{(q)}_k(x)\,v_k $$Il valore atteso tiene quindi conto dell’intera distribuzione e non soltanto del livello con probabilità maggiore.
Per esempio, se la probabilità è concentrata sui livelli 4 e 5, il valore atteso sarà compreso tra questi due valori, anche se nessuno dei due ha necessariamente una probabilità superiore al 50%.
Parametri
I parametri del modello sono raccolti in
$$ \phi = (\theta, W_1, b_1, \dots, W_Q, b_Q) $$cioè i parametri $\theta$ dell’encoder e quelli di tutte le head.
Le temperature $T_1, \dots, T_Q$ sono tenute a parte. I parametri $\theta$ partono dai valori stimati dagli autori di mmBERT durante il pre-training, l’addestramento iniziale su grandi quantità di testo. Le head partono da valori casuali.
Le temperature si stimano per ultime, con $\phi$ fissato.
Perché ho scelto l’encoder
Le due architetture fanno essenzialmente la stessa cosa, ma in modo diverso. Nel decoder, la domanda viene inserita insieme al testo e modifica la rappresentazione che il modello costruisce. Nell’encoder, invece, il testo viene rappresentato una sola volta da un vettore $h(x)$, mentre ogni domanda è associata a una piccola head che trasforma quel vettore in probabilità sulle risposte possibili.
Il confronto riguarda il caso verticale, cioè un dominio ristretto in cui le domande sono note e si dispone di esempi etichettati.
Costo di calcolo
L’encoder legge il testo una sola volta. Una volta ottenuto $h(x)$, rispondere a una domanda significa soltanto applicare la relativa head, un’operazione molto piccola.
Il decoder deve invece elaborare anche la domanda e, soprattutto, è un modello molto più grande: mmBERT-base ha circa 110 milioni di parametri, esclusi gli embedding (circa 307 milioni in tutto, perché il vocabolario di 256.000 token occupa da solo quasi 200 milioni di parametri), mentre un decoder capace di comprendere domande scritte può averne oltre un miliardo. Il vantaggio dell’encoder cresce quindi sia con la dimensione del modello sia con il numero di domande.
Uno stato che si riusa
L’encoder comprime il testo in un solo vettore $h$, di 768 valori, che può essere riutilizzato per tutte le domande.
Nel decoder, invece, la rappresentazione del testo viene mantenuta in una struttura molto più grande, la KV cache. Inoltre, con l’attenzione bidirezionale, aggiungere la domanda cambierebbe anche la rappresentazione del testo: la cache non potrebbe quindi essere semplicemente riutilizzata. Nell’encoder il problema non esiste, perché la domanda non entra nella sequenza: il testo viene letto una sola volta per costruzione.
Probabilità direttamente sulle risposte
Nel decoder la probabilità viene inizialmente distribuita sui token dell’intero vocabolario e solo dopo ristretta alle risposte ammesse. Nell’encoder, invece, la softmax viene applicata direttamente alle risposte possibili.
Questo rende anche l’addestramento più diretto: la head impara esattamente la distribuzione che verrà utilizzata in fase di risposta. Minimizzando la negative log-likelihood, il modello viene incentivato ad assegnare a ogni risposta una probabilità vicina a quella osservata nei dati.
Un decoder usato senza fine-tuning non ha questa garanzia: è stato addestrato soprattutto a prevedere il token successivo e a seguire istruzioni, non a produrre probabilità calibrate sulle poche risposte del dominio.
Una calibrazione per domanda
Ogni domanda ha inoltre una propria temperatura $T_q$, che permette di calibrare separatamente le probabilità. Nell’encoder ogni head ha la propria temperatura, quindi questa correzione non modifica le altre domande.
Adattamento al dominio
Il vantaggio diventa particolarmente evidente quando il modello deve essere adattato a un dominio specifico. Con mmBERT il fine-tuning completo è abbastanza leggero da poter essere eseguito su una singola scheda grafica; un decoder con oltre un miliardo di parametri richiede invece molta più memoria e spesso tecniche come LoRA, che permettono di addestrare solo una piccola parte dei parametri.
Che cosa si perde
L’encoder è meno flessibile. Non comprende domande scritte liberamente e non può gestire facilmente una domanda mai vista: per ogni nuova domanda servono esempi etichettati e una nuova head. Ha inoltre meno conoscenza generale di un grande decoder.
Nel caso verticale, però, le domande sono note e stabili. Per questo l’encoder può sfruttare proprio questa limitazione per essere più semplice, economico e diretto.
Note su addestramento e calibrazione
Di seguito riporto per intero tutti gli appunti presi per l’addestramento e la calibrazione. Ho avuto poco tempo per riorganizzarli, spero siano sufficientemente comprensibili.
Addestramento
Loss
Il training set contiene $N$ esempi. L’esempio $j$ è formato da un testo $x_j$ e da un’etichetta $y_{j,q} \in \mathcal{Y}_q$ per ogni domanda, cioè la risposta corretta.
Non tutti gli esempi devono avere un’etichetta per ogni domanda, quindi è una buona idea usare un indicatore:
$$ \delta_{j,q} = \begin{cases} 1 & \text{se l'esempio } j \text{ ha l'etichetta della domanda } q, \\ \\ 0 & \text{altrimenti}, \end{cases} \qquad N_q = \sum_{j=1}^{N} \delta_{j,q} $$dove $N_q$ è il numero di esempi etichettati per la domanda $q$.
La loss della domanda $q$ è la NLL ( Negative Log-Likelihood Loss) media sugli esempi etichettati, e la loss complessiva è la somma pesata delle loss delle singole domande.
$$ \mathcal{L}_q(\phi) = -\frac{1}{N_q} \sum_{j=1}^{N} \delta_{j,q} \, \log p^{(q)}_{y_{j,q}}(x_j; \phi), \qquad \mathcal{L}(\phi) = \sum_{q=1}^{Q} w_q \, \mathcal{L}_q(\phi) $$Nella prima formula $p^{(q)}_{y_{j,q}}(x_j; \phi)$ è la probabilità che il modello, con parametri $\phi$, assegna alla risposta corretta dell’esempio $j$.
Il logaritmo di una probabilità è negativo, quindi il segno meno rende la loss positiva.
Il termine vale $0$ quando il modello dà probabilità $1$ alla risposta corretta e cresce senza limite quando questa probabilità tende a $0$. Nella seconda formula $w_q > 0$ è il peso della domanda $q$, che vale $1$ se non indicato diversamente.
Se in un mini-batch, il piccolo gruppo di esempi usato a ogni passo di addestramento, nessun esempio è etichettato per $q$, il termine $\mathcal{L}_q$ viene omesso (src/losses.py).
Cooperazione tra le domande
Le head sono isolate, ma l’encoder è condiviso. Il gradiente della loss rispetto ai parametri dell’encoder, cioè il vettore delle derivate rispetto a ciascun parametro in $\theta$, è la somma pesata dei gradienti delle singole domande
$$ \nabla_\theta \mathcal{L} = \sum_{q=1}^{Q} w_q \, \nabla_\theta \mathcal{L}_q , $$perché la derivata di una somma è la somma delle derivate. L’encoder viene quindi modificato da tutte le domande insieme, e $h$ diventa utile a tutte. I pesi $w_q$ regolano quanto conta ciascuna.
Gradiente sui logit e overconfidence
Per un singolo esempio con risposta corretta $y$ e probabilità $p = \mathrm{softmax}(z)$, la derivata della NLL rispetto al logit $z_k$ è
$$ \frac{\partial \, (-\log p_y)}{\partial z_k} = p_k - \mathbb{1}[y = k] $$dove $\mathbb{1}[y = k]$ vale $1$ se $k$ è la risposta corretta e $0$ altrimenti.
Per la risposta corretta la derivata vale $p_y - 1$, che è negativa, quindi l’addestramento alza il suo logit.
Per le altre risposte vale $p_k$, che è positiva, quindi l’addestramento abbassa i loro logit.
Questa parte la trovo interessante, perché la “spinta” si esaurisce solo quando $p_y = 1$.
Su un training set finito le differenze tra i logit continuano quindi a crescere, e il modello diventa overconfident, cioè più sicuro di quanto giustificato, sui testi nuovi.
Per questo la calibration è un passo separato e fondamentale dell’architettura.
Ottimizzazione
Il fine-tuning è full, perché aggiorna tutti i parametri $\phi$, “supervisionati” perché impara da esempi etichettati. Inoltre è multi-task, perché addestra tutte le domande sullo stesso encoder.
Si usano:
- AdamW con learning rate $\eta = 3 \cdot 10^{-5}$, il numero che regola l’ampiezza di ogni passo di aggiornamento;
- un warm-up, in cui il learning rate cresce linearmente da $0$ a $\eta$ nel primo 10% dei passi, seguito da una discesa lineare fino a $0$;
- un weight decay $\lambda = 0{,}01$, che a ogni passo riduce leggermente tutti i parametri per scoraggiare valori troppo grandi;
- un gradient clipping con soglia $\gamma = 1$, che riduce il gradiente quando la sua lunghezza supera $\gamma$, senza cambiarne la direzione.
L’addestramento procede per epoch, cioè passaggi completi sul training set, al massimo 5.
Indicando con $\phi_e$ i parametri alla fine dell’epoch $e$ e con $\mathcal{L}_{q, \mathrm{val}}$ la loss della domanda $q$ calcolata sul validation set, l’early stopping conserva i parametri dell’epoch
$$ e^{*} = \arg\min_{e} \sum_{q=1}^{Q} w_q \, \mathcal{L}_{q, \mathrm{val}}(\phi_e) $$cioè quella con la loss di validation più bassa. L’addestramento si interrompe alla prima epoch in cui la loss di validation non migliora, quindi il minimo è calcolato sulle epoch effettivamente eseguite. Il criterio usa la NLL e non l’accuracy, la frazione di risposte corrette, perché l’obiettivo è la qualità dell’intera distribuzione.
Calibrazione
Una head è calibrata quando la sua confidenza riflette correttamente la probabilità di essere nel giusto: tra le previsioni a cui assegna confidenza $c$, circa una frazione $c$ dovrebbe essere corretta.
Per misurare questa proprietà si dividono le $N_{\mathrm{eval}}$ previsioni dell’insieme di valutazione in $G=10$ gruppi, detti bin, in base alla confidenza.
Il bin $B_g$, con $g=1,\dots,G$, raccoglie le previsioni con confidenza compresa tra $(g-1)/10$ e $g/10$.
Per ogni bin si confrontano la confidenza media, $\mathrm{conf}(B_g)$, e l’accuracy, $\mathrm{acc}(B_g)$, cioè la frazione di risposte corrette.
Se, per esempio, un bin ha confidenza media 0,8, una head ben calibrata dovrebbe essere corretta in circa l'80% dei casi.
La ECE (Expected Calibration Error) riassume questi scarti in un unico numero, dando più peso ai bin che contengono più previsioni:
$$ \mathrm{ECE} = \sum_{g=1}^{G} \frac{|B_g|}{N_{\mathrm{eval}}} \left| \mathrm{acc}(B_g)-\mathrm{conf}(B_g) \right|. $$Più la ECE è bassa, più la confidenza è coerente con la frequenza effettiva degli errori.
Temperature scaling
Ora, questa è la parte che reputo più importante.
La calibrazione aggiunge a ogni head un solo parametro, la temperatura $T_q > 0$. Prima della softmax tutti i logit della head vengono divisi per lo stesso numero $T_q$
$$ p^{(q, T_q)}_k(x) = \frac {\exp\big(z^{(q)}_k / T_q\big)} { \sum_{k'=1}^{K_q} \exp\big(z^{(q)}_{k'} / T_q\big) } $$dove l’apice $(q, T_q)$ indica la distribuzione della domanda $q$ calcolata con temperatura $T_q$.
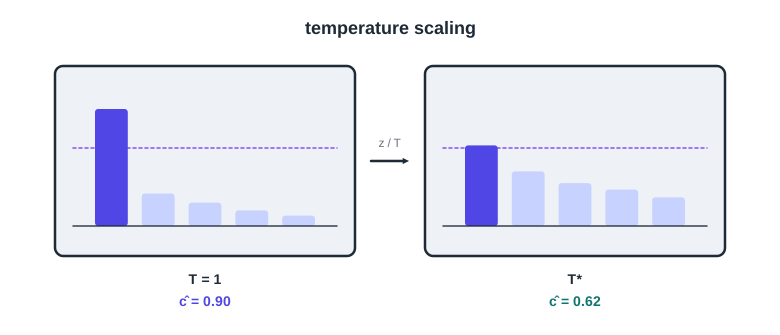
A sinistra la distribuzione grezza (T = 1). La confidenza ĉ = 0,90 è molto più alta della frequenza osservata (linea tratteggiata). A destra, dopo aver diviso i logit per la temperatura ottimale T*, la confidenza scende a 0,62 e coincide con la frequenza osservata.
Il metodo è stato proposto da Guo et alii nel 2017 (“On Calibration of Modern Neural Networks”)
proprio per correggere l’eccesso di confidenza che possono accumulare le reti neurali moderne.
Come si sceglie la temperatura
La temperatura si sceglie minimizzando la NLL sul validation set. La NLL è adatta a questo scopo perché è una strictly proper scoring rule e quindi premia probabilità che riflettono correttamente la distribuzione dei dati. Inoltre è una funzione regolare rispetto alla temperatura e può essere minimizzata con metodi numerici standard.
La ECE non si presta altrettanto bene all’ottimizzazione. Dipende dalla scelta dei bin e varia a salti quando una previsione passa da un bin all’altro. Si usa il validation set anziché il training set perché sul training la rete tende a essere troppo sicura delle proprie previsioni.
È più comodo lavorare con l’inverso della temperatura,
$$ \beta=\frac{1}{T}. $$Per una head fissata, siano $z_j=(z_{j,1},\dots,z_{j,K})$ i logit dell’esempio $j$ e $y_j$ la risposta corretta. La NLL media è
$$ \ell(\beta)= \frac{1}{N_{\mathrm{val}}} \sum_j \delta_j \left( -\beta z_{j,y_j} + \log\sum_k e^{\beta z_{j,k}} \right). $$Il parametro $\beta$ controlla quanto le differenze tra i logit si riflettono nelle probabilità. Se $\beta$ aumenta, la distribuzione diventa più concentrata sulla risposta con logit maggiore. Se $\beta$ diminuisce, le probabilità diventano più uniformi.
La funzione $\ell(\beta)$ è convessa. La sua derivata seconda è infatti una media di varianze dei logit, pesate con le probabilità del modello, e quindi non può essere negativa. Se almeno un esempio ha logit diversi tra loro, la funzione è strettamente convessa e possiede al più un minimo.
Poiché $\ell$ è convessa, la derivata $\ell'$ è crescente. Il minimo esiste se $\ell'$ passa da valori negativi a valori positivi, e per stabilirlo basta guardare che cosa succede ai due estremi di $\beta$.
Per $\beta\to0$, cioè $T\to\infty$, la distribuzione diventa uniforme. Ogni risposta ha probabilità $1/K$ e il logit atteso coincide con la media dei logit dell’esempio,
$\bar z_j=\frac{1}{K}\sum_k z_{j,k}.$
Di conseguenza,
$\ell'(0)= \frac{1}{N_{\mathrm{val}}} \sum_j\delta_j \big(\bar z_j-z_{j,y_j}\big).$
Questa quantità è negativa quando, in media, il logit della risposta corretta è maggiore della media dei logit. È ciò che ci aspettiamo da una head che abbia imparato a distinguere almeno in parte le risposte.
All’estremo opposto, per $\beta\to\infty$, cioè $T\to0$, la distribuzione si concentra sulla risposta con logit massimo. Si ottiene quindi
$\lim_{\beta\to\infty}\ell'(\beta) = \frac{1}{N_{\mathrm{val}}} \sum_j\delta_j \big( \max_k z_{j,k}-z_{j,y_j} \big) \geq0.$
Ogni termine è nullo quando la risposta prevista è corretta e positivo quando è sbagliata. Se la head sbaglia almeno un esempio, il limite è quindi positivo.
Una temperatura ottimale finita esiste quando la head ha imparato qualcosa ma commette anche qualche errore sul validation set. Gli altri due casi hanno un’interpretazione semplice. Se la head non sbaglia mai, la NLL continua a diminuire quando $T$ tende a zero e la temperatura ottimale sarebbe $T=0$. Se invece i logit non contengono informazione utile, la NLL viene minimizzata facendo tendere $T$ a infinito e rendendo la distribuzione uniforme.
Per questo la ricerca è limitata all’intervallo
$T_q\in[0{,}05;\,20].$
Il limite inferiore impedisce alla temperatura di collassare a zero, mentre quello superiore impedisce che cresca senza limite. Se la temperatura stimata finisce vicino a uno dei due estremi, il risultato non va interpretato come una buona calibrazione. È piuttosto un segnale che il validation set non contiene abbastanza informazione per stimare una temperatura finita.
Dall’output alle decisioni
Per ogni testo e ogni domanda il sistema restituisce la distribuzione calibrata:
- la distribuzione calibrata $p^{(q)}(x)$;
- la risposta prevista $\hat{y}^{(q)}$ e la sua probabilità $\hat{c}^{(q)}$;
- il valore atteso $\mathbb{E}^{(q)}(x)$ per le domande
score.
Le probabilità servono a scegliere l’azione tenendo conto del costo degli errori. Per una domanda sì/no, per esempio, si può scegliere tra agire e non agire. Se $\kappa_{\mathrm{FP}}$ è il costo di un falso positivo e $\kappa_{\mathrm{FN}}$ quello di un falso negativo, conviene agire quando
$p_{\mathrm{sì}} > \frac{\kappa_{\mathrm{FP}}} {\kappa_{\mathrm{FP}}+\kappa_{\mathrm{FN}}}.$
La soglia dipende quindi dai costi degli errori.
Questa regola è affidabile solo se le probabilità sono calibrate. La calibration non è quindi un dettaglio dell’output, ma ciò che permette di usarlo per prendere decisioni.
Per lo stesso motivo Jev restituisce distribuzioni anziché semplici etichette e TypeSafe dedica una fase specifica dell’addestramento alla loro calibrazione, basata su una tecnica di Reinforcement Learning che chiama RLCD.
Il passaggio a un nuovo dominio non richiede di cambiare le formule. Occorre solo fissare:
- il numero di domande $Q$;
- le risposte possibili $\mathcal{Y}_q$ per ciascuna domanda;
- il tipo di domanda e, per le domande
score, i livelli $v_k$; - i pesi $w_q$ della loss.
Da questa configurazione dipendono le dimensioni delle matrici $W_q$ e il numero di temperature da calibrare.
Buon divertimento